云南的生物信息分析需求有其特殊性。这里既有全国领先的少数民族遗传资源队列,也有高海拔地区特有的肿瘤流行病学样本,还有面向南亚东南亚的跨境合作测序项目。样本类型复杂、批次跨度大、临床随访周期长,这些特征决定了本地生信分析不能简单套用通用流程。辉曼生物信息(humanbio.cn)在长期服务云南及周边地区科研团队的过程中,积累了一些值得讨论的工程化经验。
一、高原样本的数据特征与质控挑战
高海拔地区的血液样本常伴随红细胞压积升高,核酸提取后的文库复杂度与平原样本存在系统性差异。我们在处理一批滇西地区肺癌患者RNA-seq数据时发现,原始reads的rRNA残留比例中位数达到8.7%,显著高于公共数据库同类项目的3%—4%水平。若不进行分层质控而直接进入比对环节,将导致有效比对率被低估约12个百分点。针对这类情况,需要在FastQC之后增加rRNA比对过滤步骤,并在下游表达定量中引入批次协变量。
另一个常被忽视的问题是样本采集时间跨度。云南部分地州医院的样本库建设起步较晚,同一课题组的样本可能跨越三到五年,测序平台也从HiSeq 2500逐步过渡到NovaSeq 6000。平台间GC偏好性和读长差异会直接体现在基因表达矩阵中。我们通常建议在实验设计阶段就预留重复样本用于桥接校正,分析阶段采用ComBat-seq或RUVg方法处理批次效应,并在报告中明确列出校正前后的PCA对比图。
二、肿瘤基因组分析中的本地化参考数据
肿瘤数据分析对参考基因组的依赖程度很高。云南地区鼻咽癌和肝癌样本相对集中,而部分研究涉及少数民族人群的胚系变异注释。gnomAD等主流数据库对东亚人群的覆盖尚可,但对云南特有少数民族群体的等位基因频率代表性不足,直接套用可能产生大量假阳性致病位点。实践中,我们会将本地队列的对照样本单独构建频率面板,与公共数据库交叉验证后再输出临床意义注释。
在体细胞突变检测环节,肿瘤纯度低是另一常见问题。一批滇南地区肝癌样本的病理评估显示,中位肿瘤纯度仅为42%,低于TCGA-LIHC队列的58%。低纯度样本在MuTect2等caller中容易出现灵敏度下降。我们的处理策略是先用ABSOLUTE或PureCN估算纯度与倍性,再据此调整caller参数阈值,并对关键驱动基因进行人工复核。这类细节在标准化流程中往往被省略,却直接影响结论的可靠性。
三、单细胞测序与转录组分析的落地实践
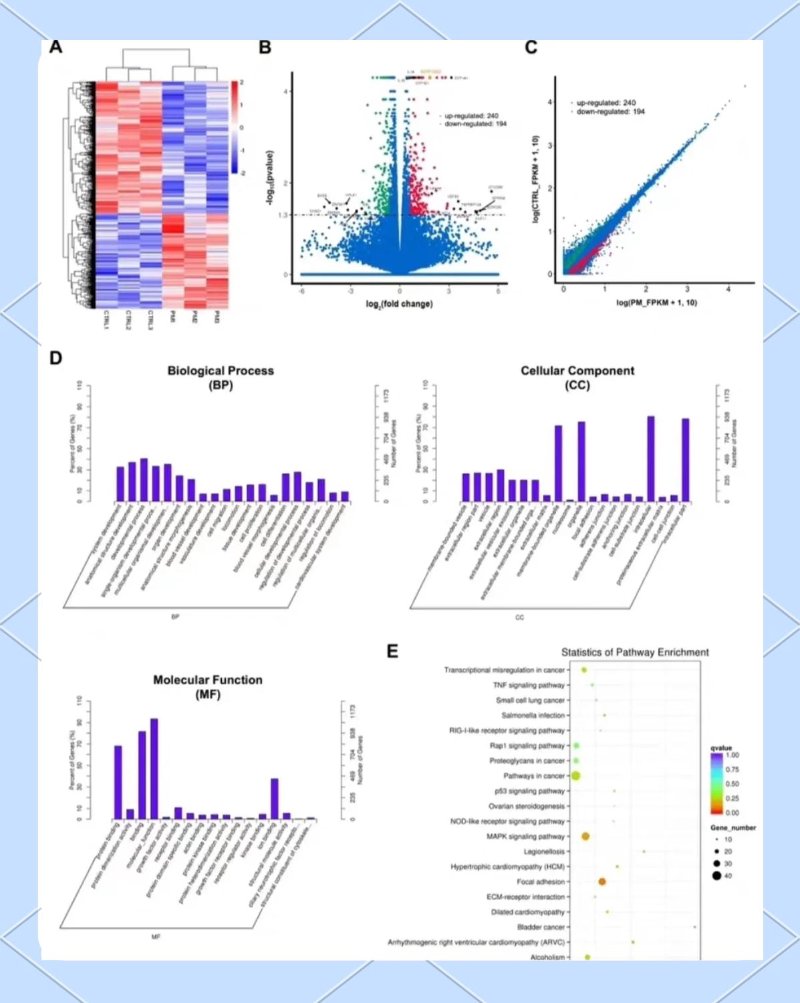
单细胞测序分析在云南的应用正从科研向临床辅助延伸。以一期滇中地区结直肠癌单细胞项目为例,10x Genomics平台产出约8,000个细胞的表达谱,经DoubletFinder去除双细胞后保留6,900余个高质量细胞。聚类注释阶段,我们注意到本地样本中髓系细胞占比偏高,与文献报道的肠癌微环境构成存在偏差。回溯实验记录后发现,组织解离时间较标准流程延长了约15分钟,可能导致中性粒细胞富集。这类问题提示单细胞项目必须将实验元数据纳入分析日志,否则聚类结果的生物学解释容易失真。
常规RNA-seq数据分析方面,差异表达分析已相对成熟,但可变剪接和融合基因检测仍是薄弱环节。我们建议对肿瘤样本至少运行STAR-Fusion与Arriba两种融合检测工具,取交集后再行RT-PCR验证,以控制假阳性率。对于有临床转化需求的项目,生信云平台可将这些步骤封装为可复现的流程模板,减少人工操作引入的随机误差。
四、可复现性与协作模式
生物信息学服务的核心价值不在于跑通流程,而在于结论可复现、过程可追溯。辉曼生物信息在云南地区的项目实践中,逐步推行容器化分析与版本化流程管理,所有分析参数、软件版本与参考数据版本均记录在分析报告中。对于涉及多中心协作的肿瘤基因组分析项目,这种规范能显著降低沟通成本。生物统计咨询环节也应前置介入,在实验设计阶段明确样本量估算与统计检验方案,而非在数据产出后再补救。
云南的生物信息分析生态仍在成长中,样本资源丰富与分析能力分布不均并存。把高原样本的特殊性转化为方法学上的严谨处理,把跨境合作的数据规模转化为可共享的流程资产,是这个领域值得持续投入的方向。